项目简介
SpeakLab 的核心思路不是整篇文章一次性合成,而是将文章拆成可独立管理的句子单元。每个句子都可以独立保存音色和参数,修改后只重新生成当前句子,避免因为一处调整而重新调用整篇文本的 TTS。
长文本自动分句
句子级配置
逐句生成与缓存
连续播放
MP3 合成导出
本地桌面应用
核心工作流
长文本 → 自动分句 → 句子级音色与参数 → 句子级生成 / 缓存 → 连续播放 / 导出
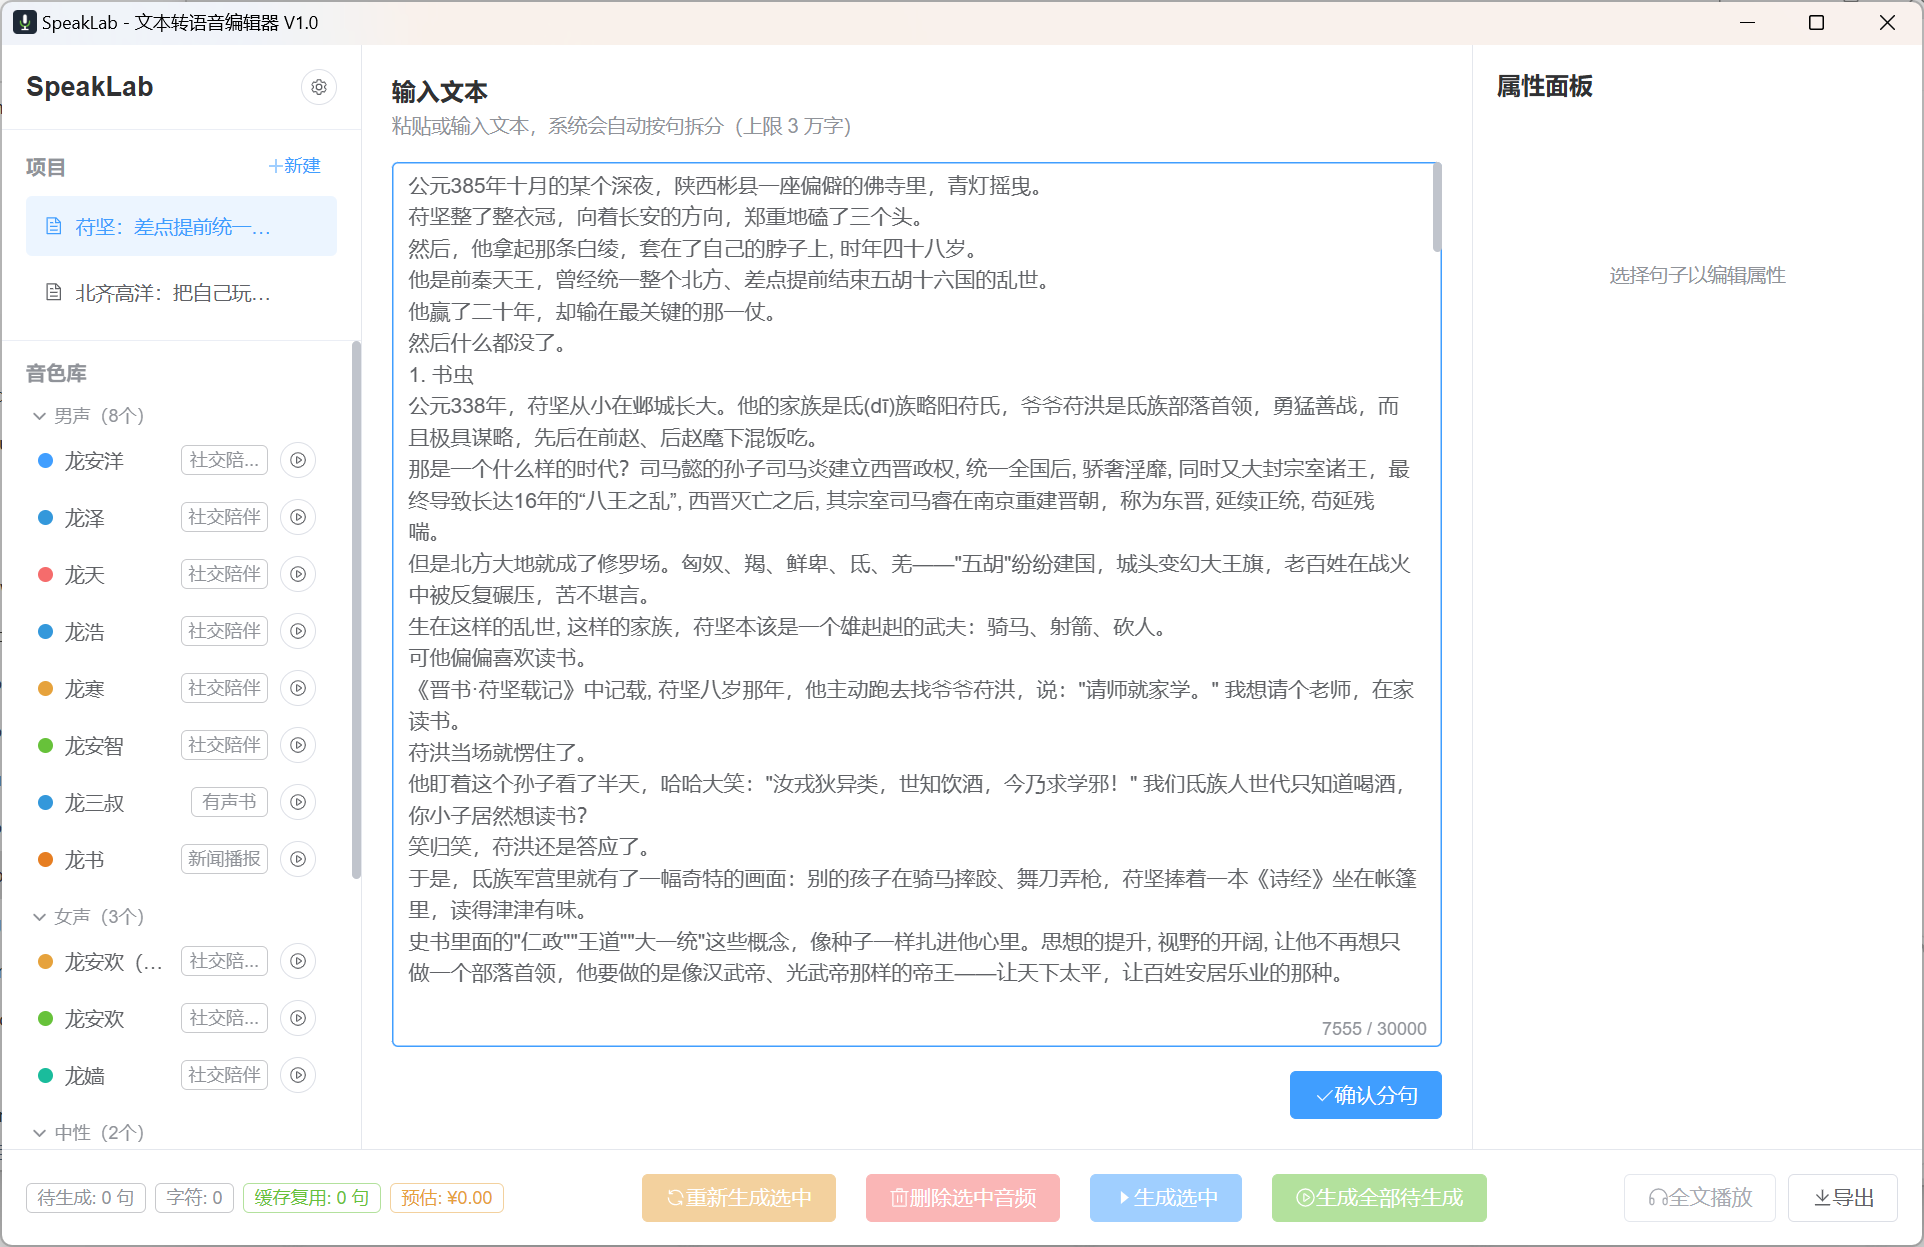
- 创建项目并输入或粘贴长文本,保留正文段落和换行格式。
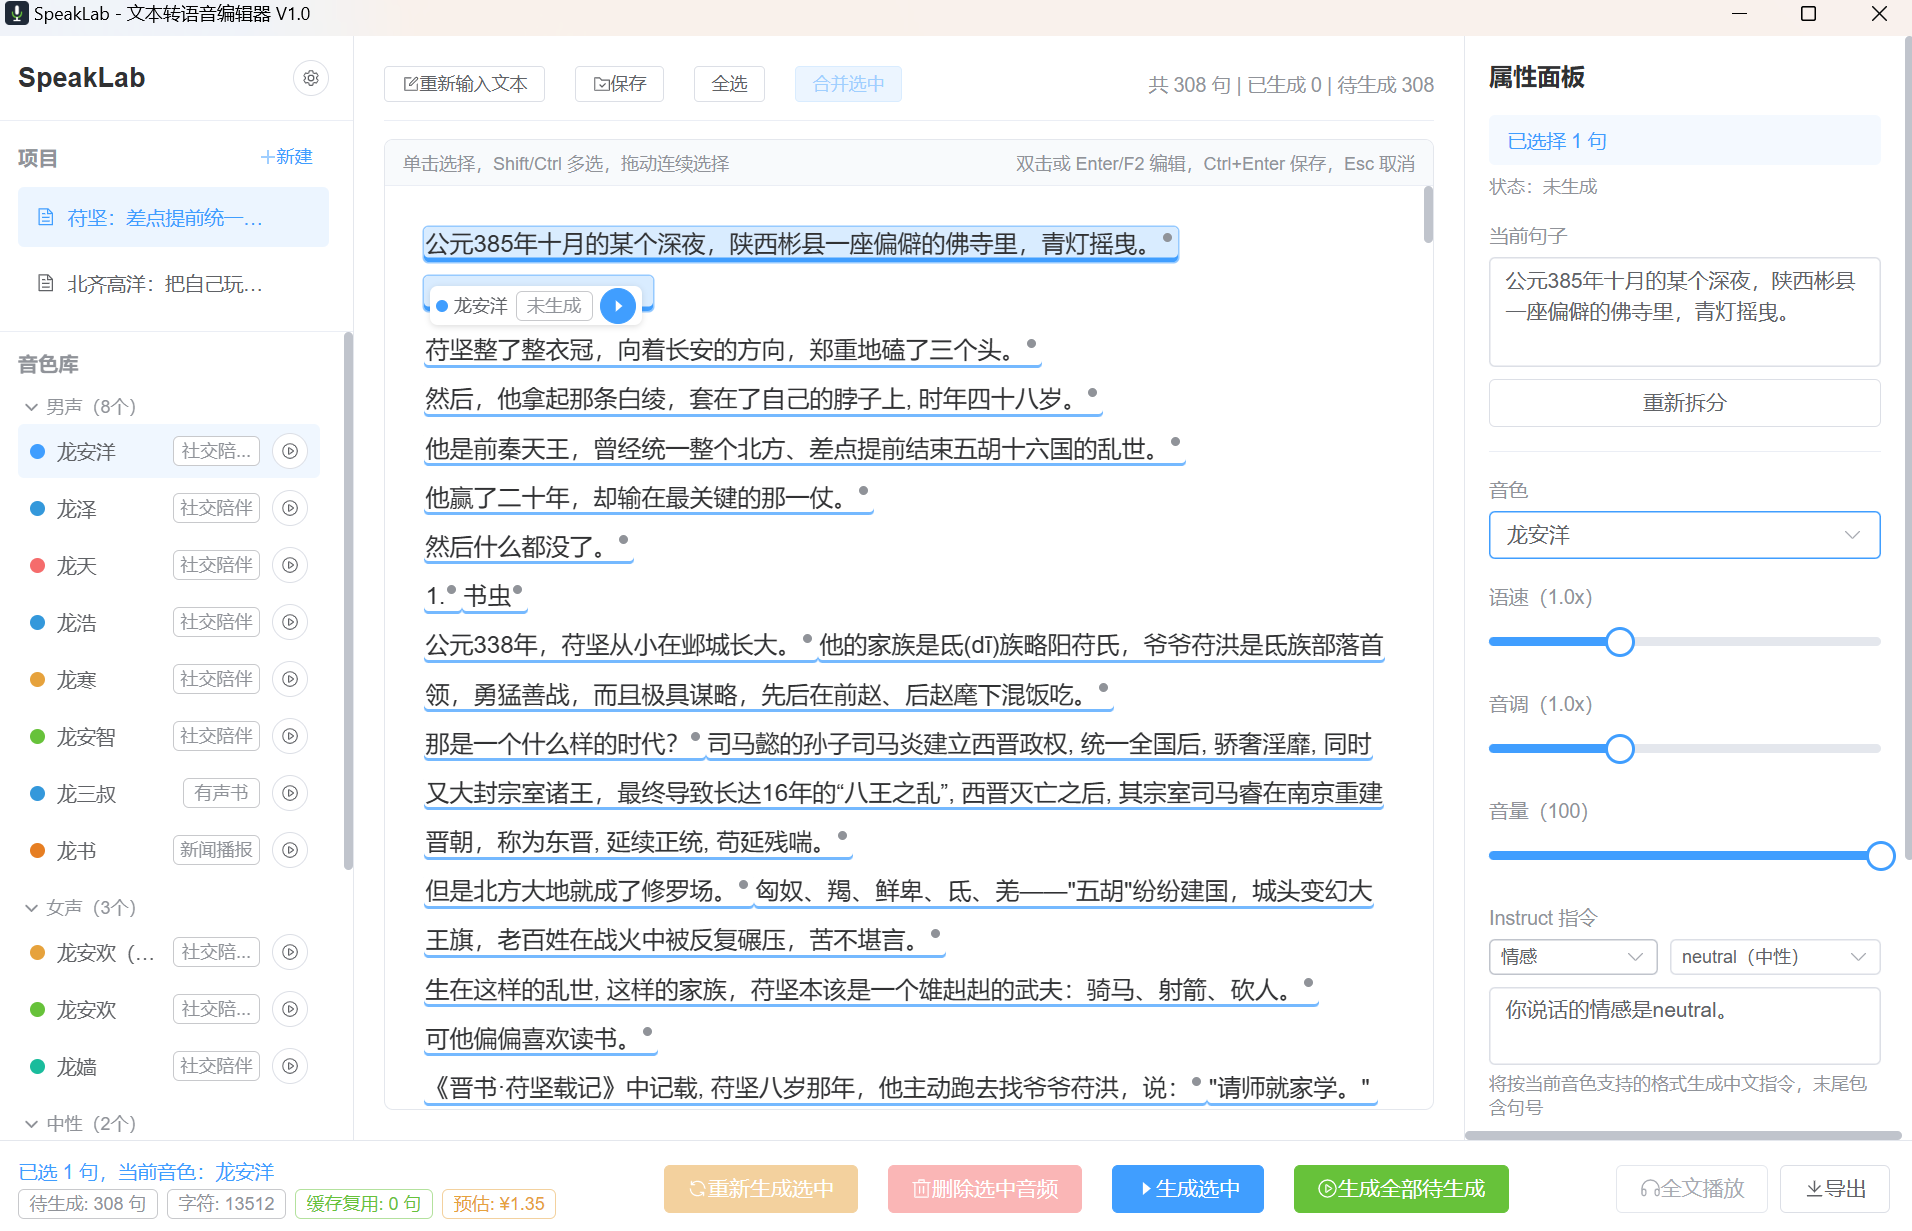
- 点击确认分句,在当前编辑器中管理每个句子。
- 为句子选择音色、模型、语速、音调、音量、情绪和场景等参数。
- 逐句试听、生成或重生成,已生成且未修改的音频继续复用。
- 按正文顺序连续播放已生成内容,或使用 FFmpeg 合成为 MP3。
核心功能
连续句子编辑器
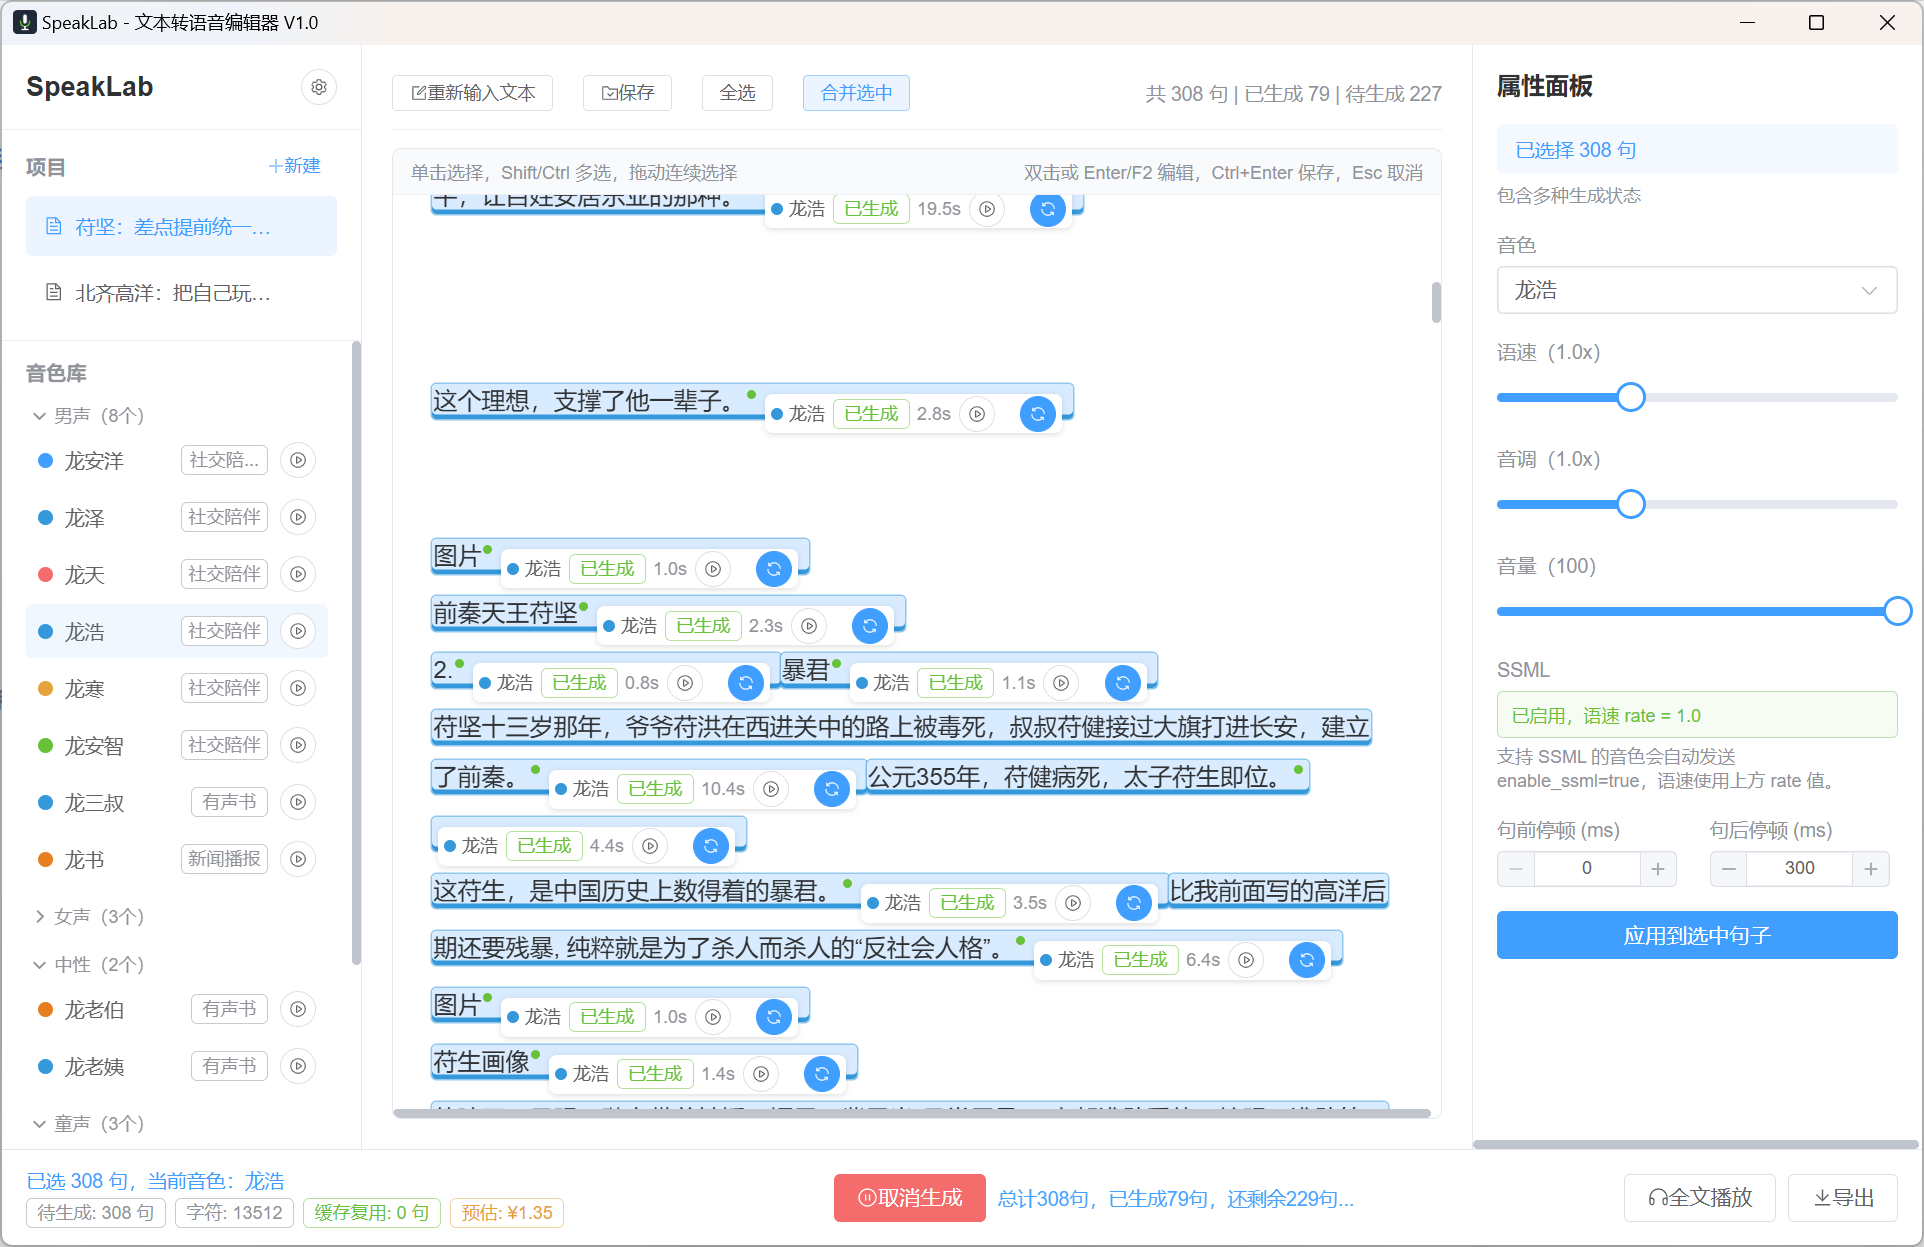
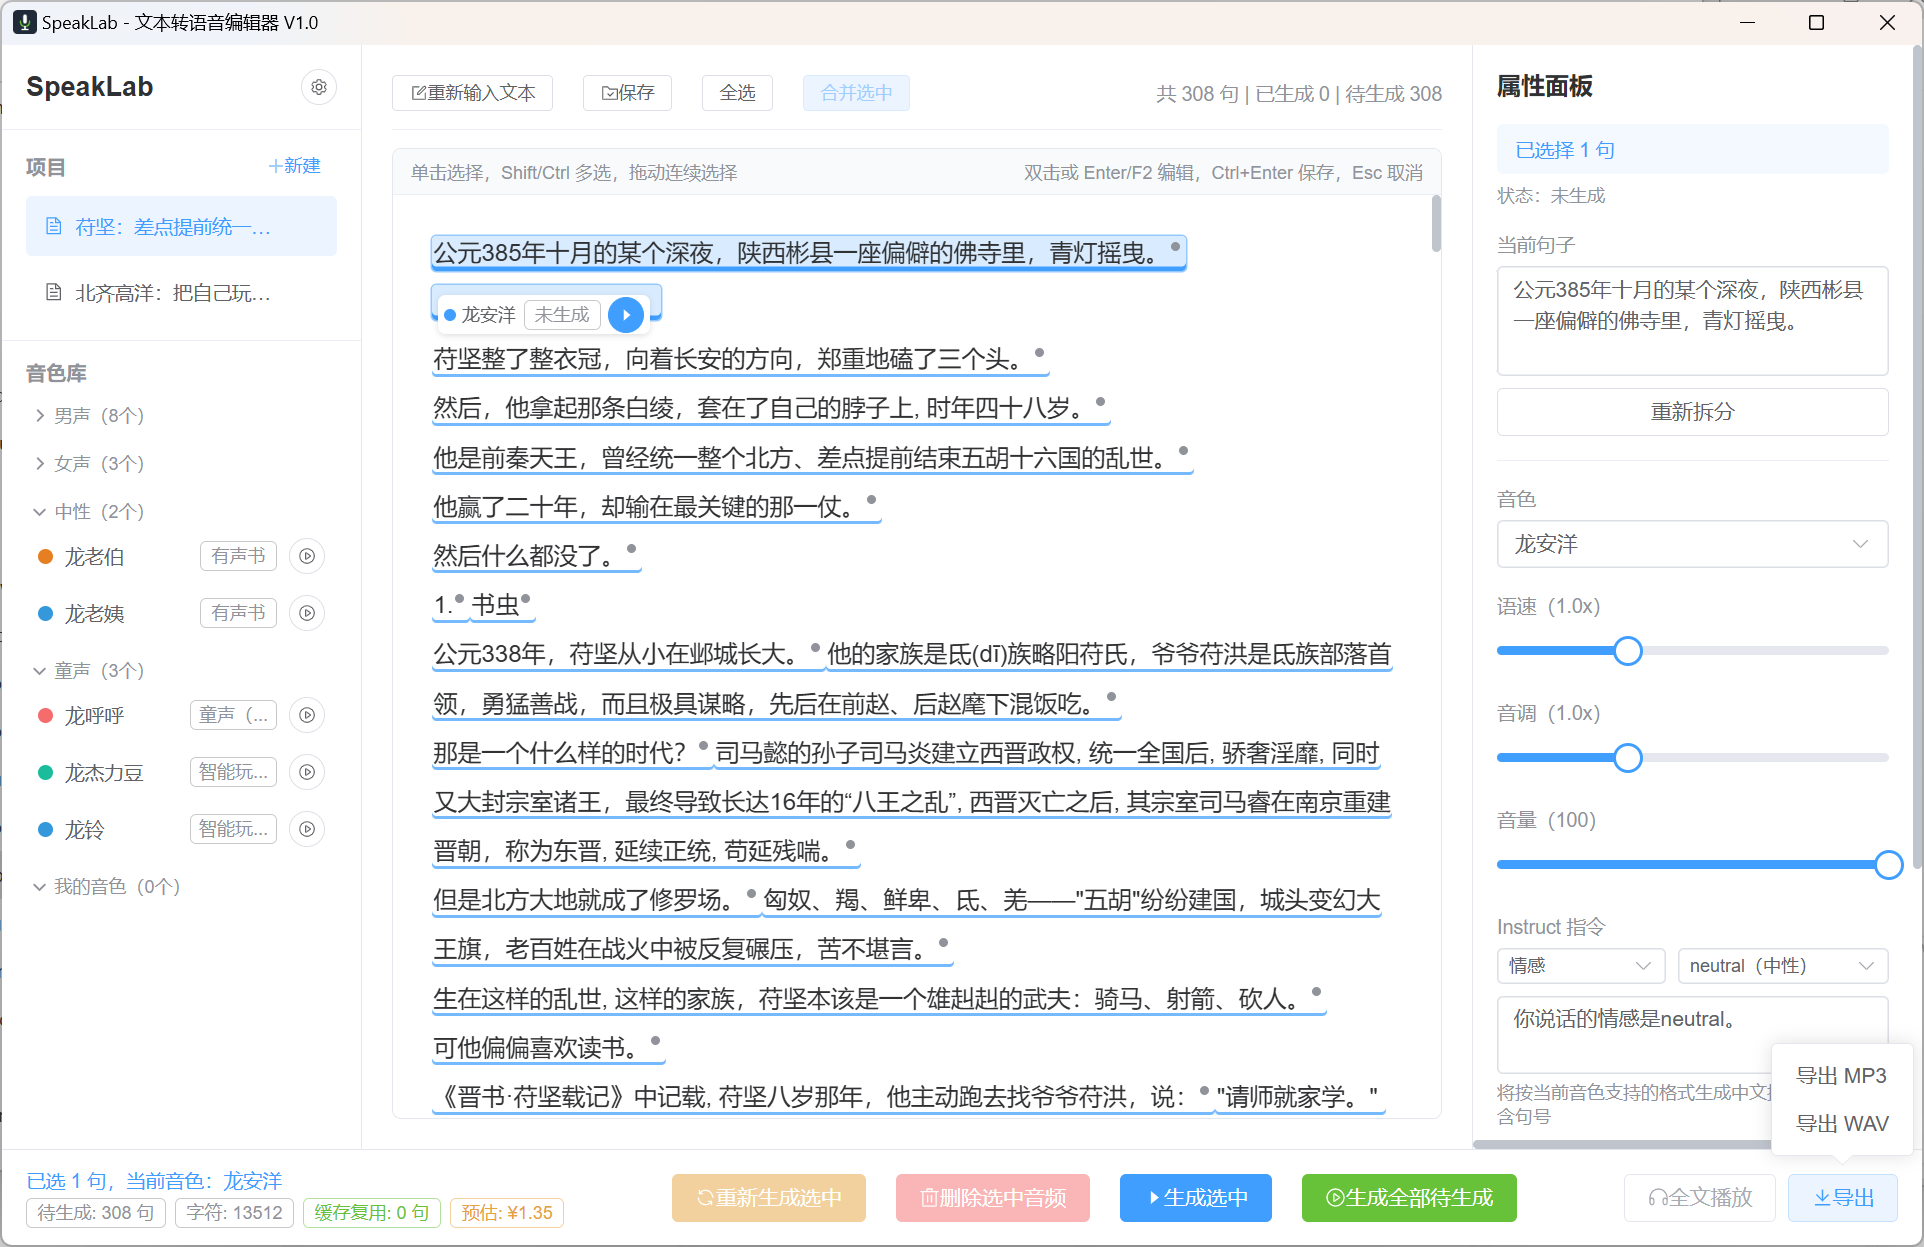
支持单击选择、Shift 连选、Ctrl 多选、拖动选择、双击或快捷键编辑句子,正文保持连续阅读体验。
音色库
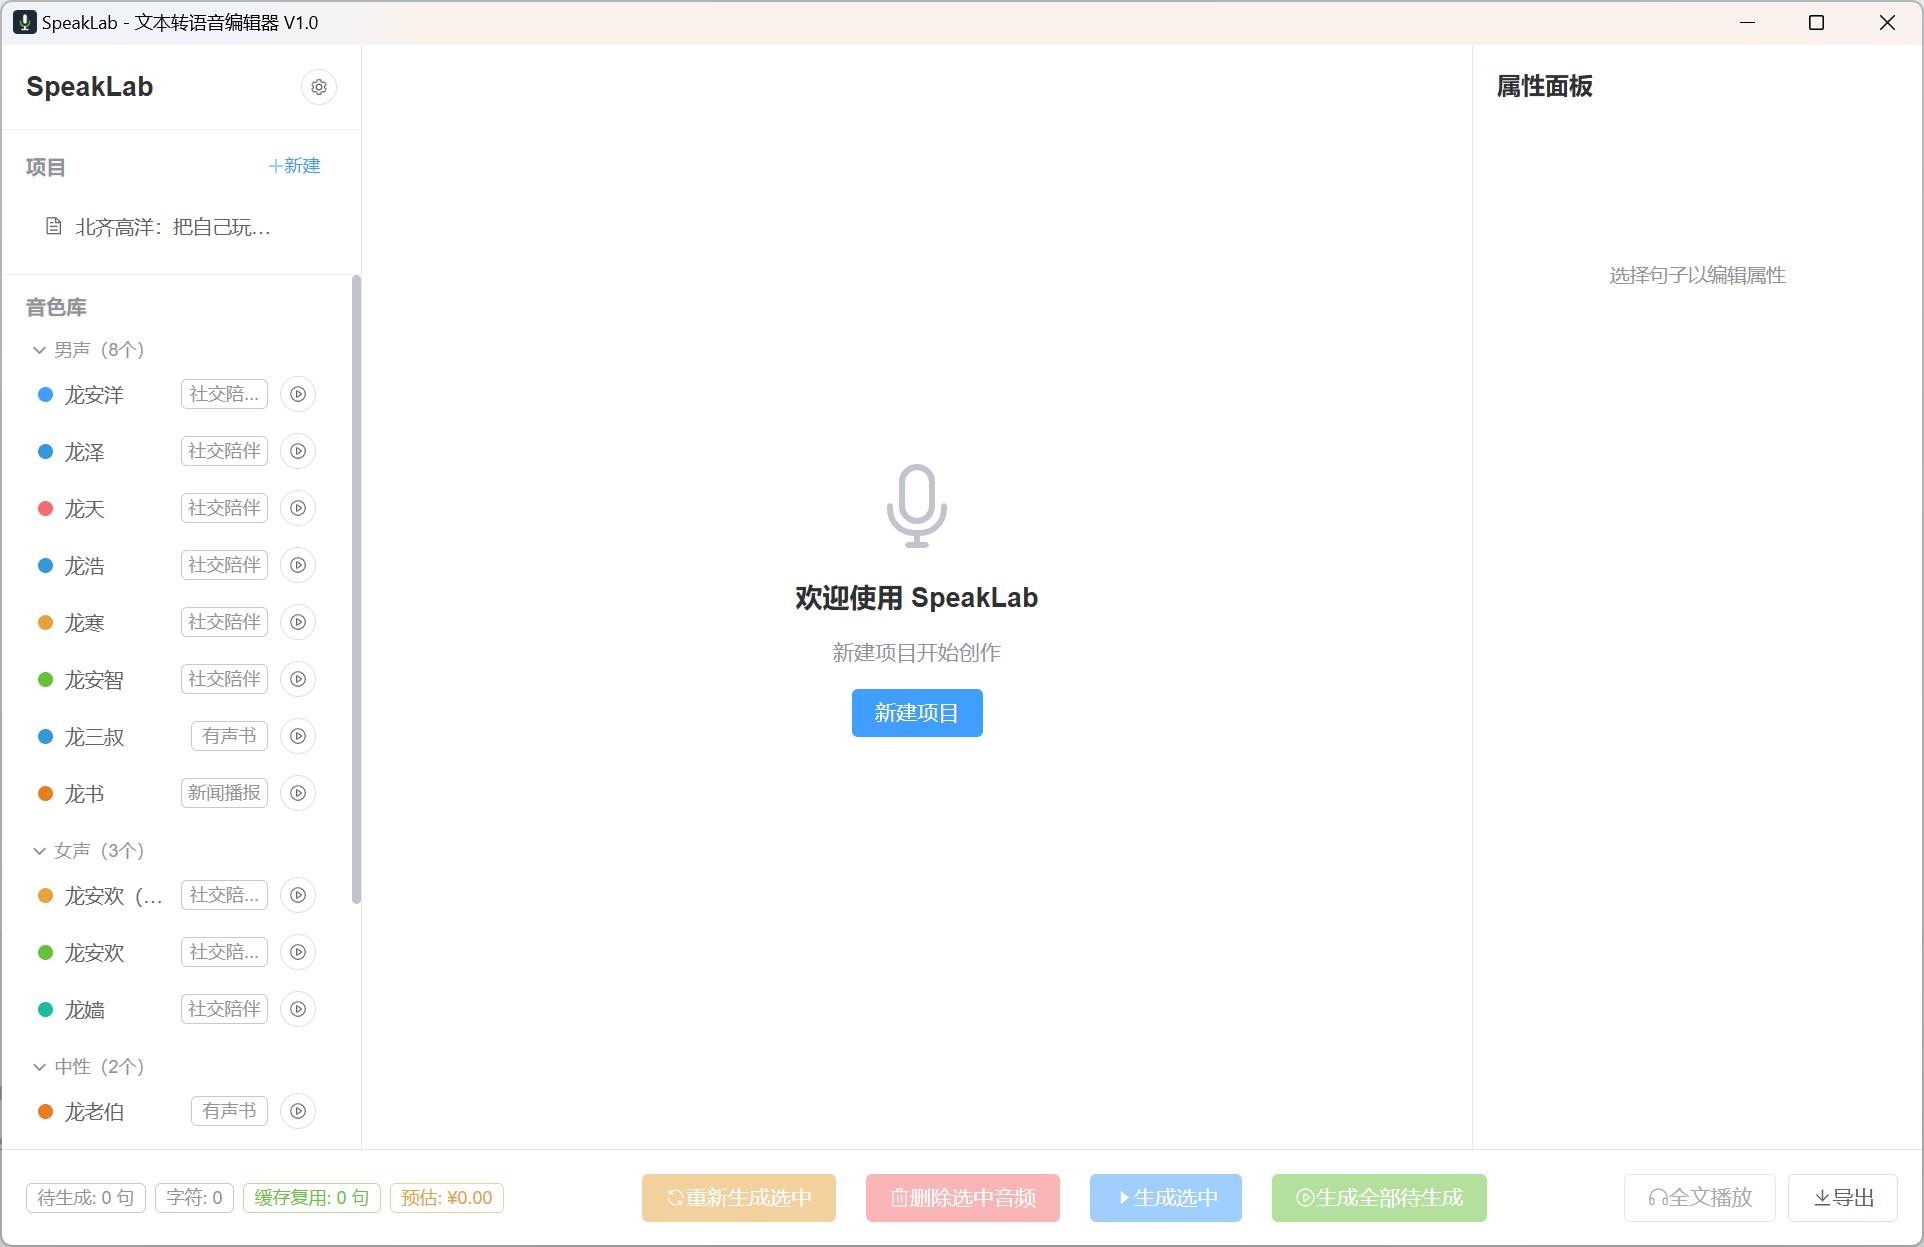
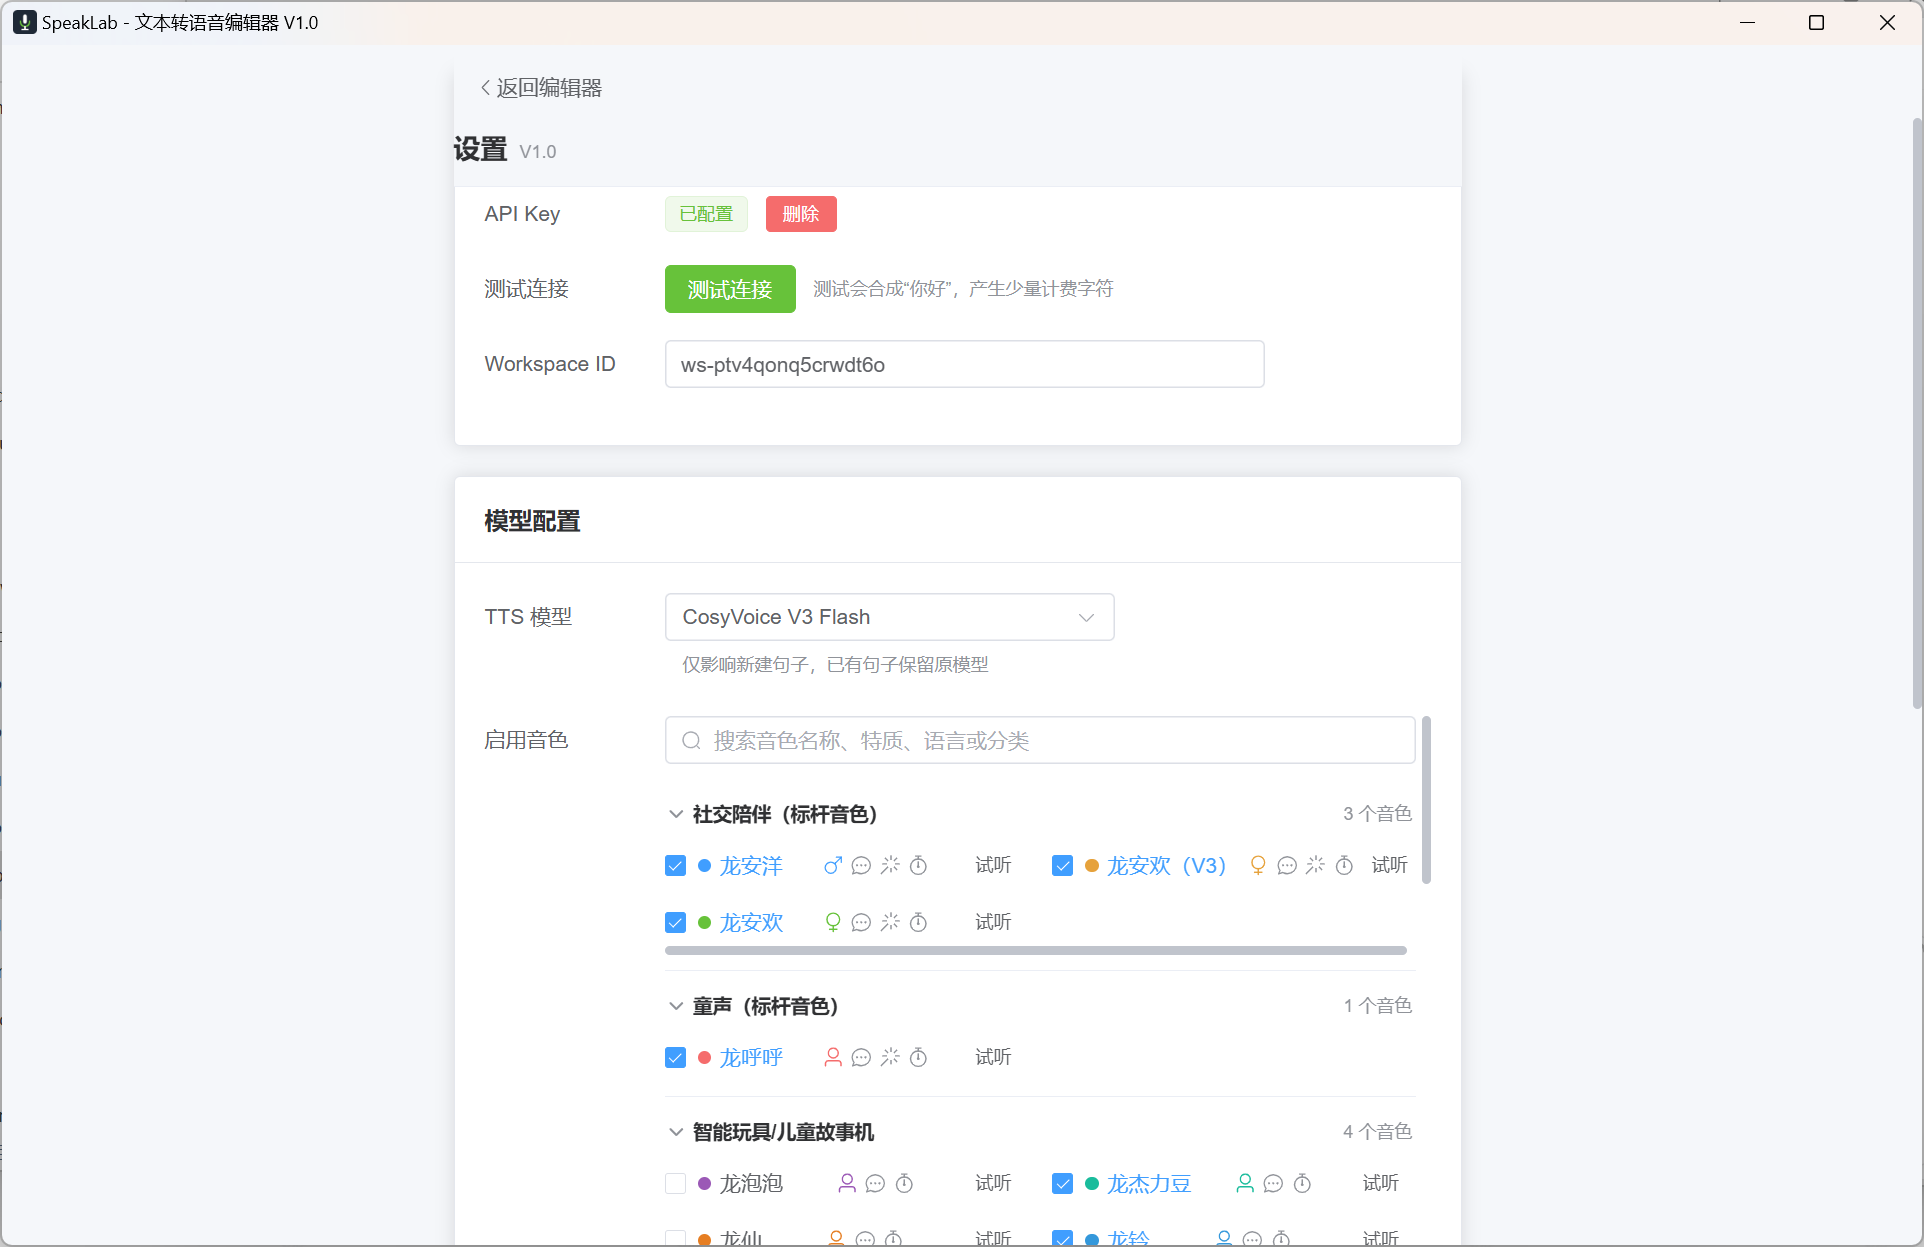
按男声、女声、中性、童声和我的音色分组管理,支持搜索、折叠分组和能力标识。
句子级参数
每句可以独立配置模型、音色、语速、音调、音量、Instruct、SSML 和时间戳等能力。
生成与缓存
支持逐句生成、批量生成和单句重生成,缓存键包含文本、音色、参数和模型版本,避免错误复用。
连续播放
按句子顺序播放已生成音频,显示当前句子和播放进度,试听其他句子时会停止全文播放。
MP3 导出
校验音频片段后,调用内置 FFmpeg 按正文顺序合并,并在导出过程中显示处理进度。
技术架构
前端界面
Vue 3、TypeScript、Vite、Element Plus、Pinia 和 Vue Router,负责编辑器交互、参数设置、播放和导出反馈。
桌面与本地能力
Tauri 2、Rust 和 SQLite,负责文件系统、数据库、资源路径、本地音频以及 FFmpeg / FFprobe 调用。
云端语音服务
当前接入阿里云百炼 CosyVoice,支持 cosyvoice-v3-flash 和 cosyvoice-v3-plus 两个模型版本。
安全存储
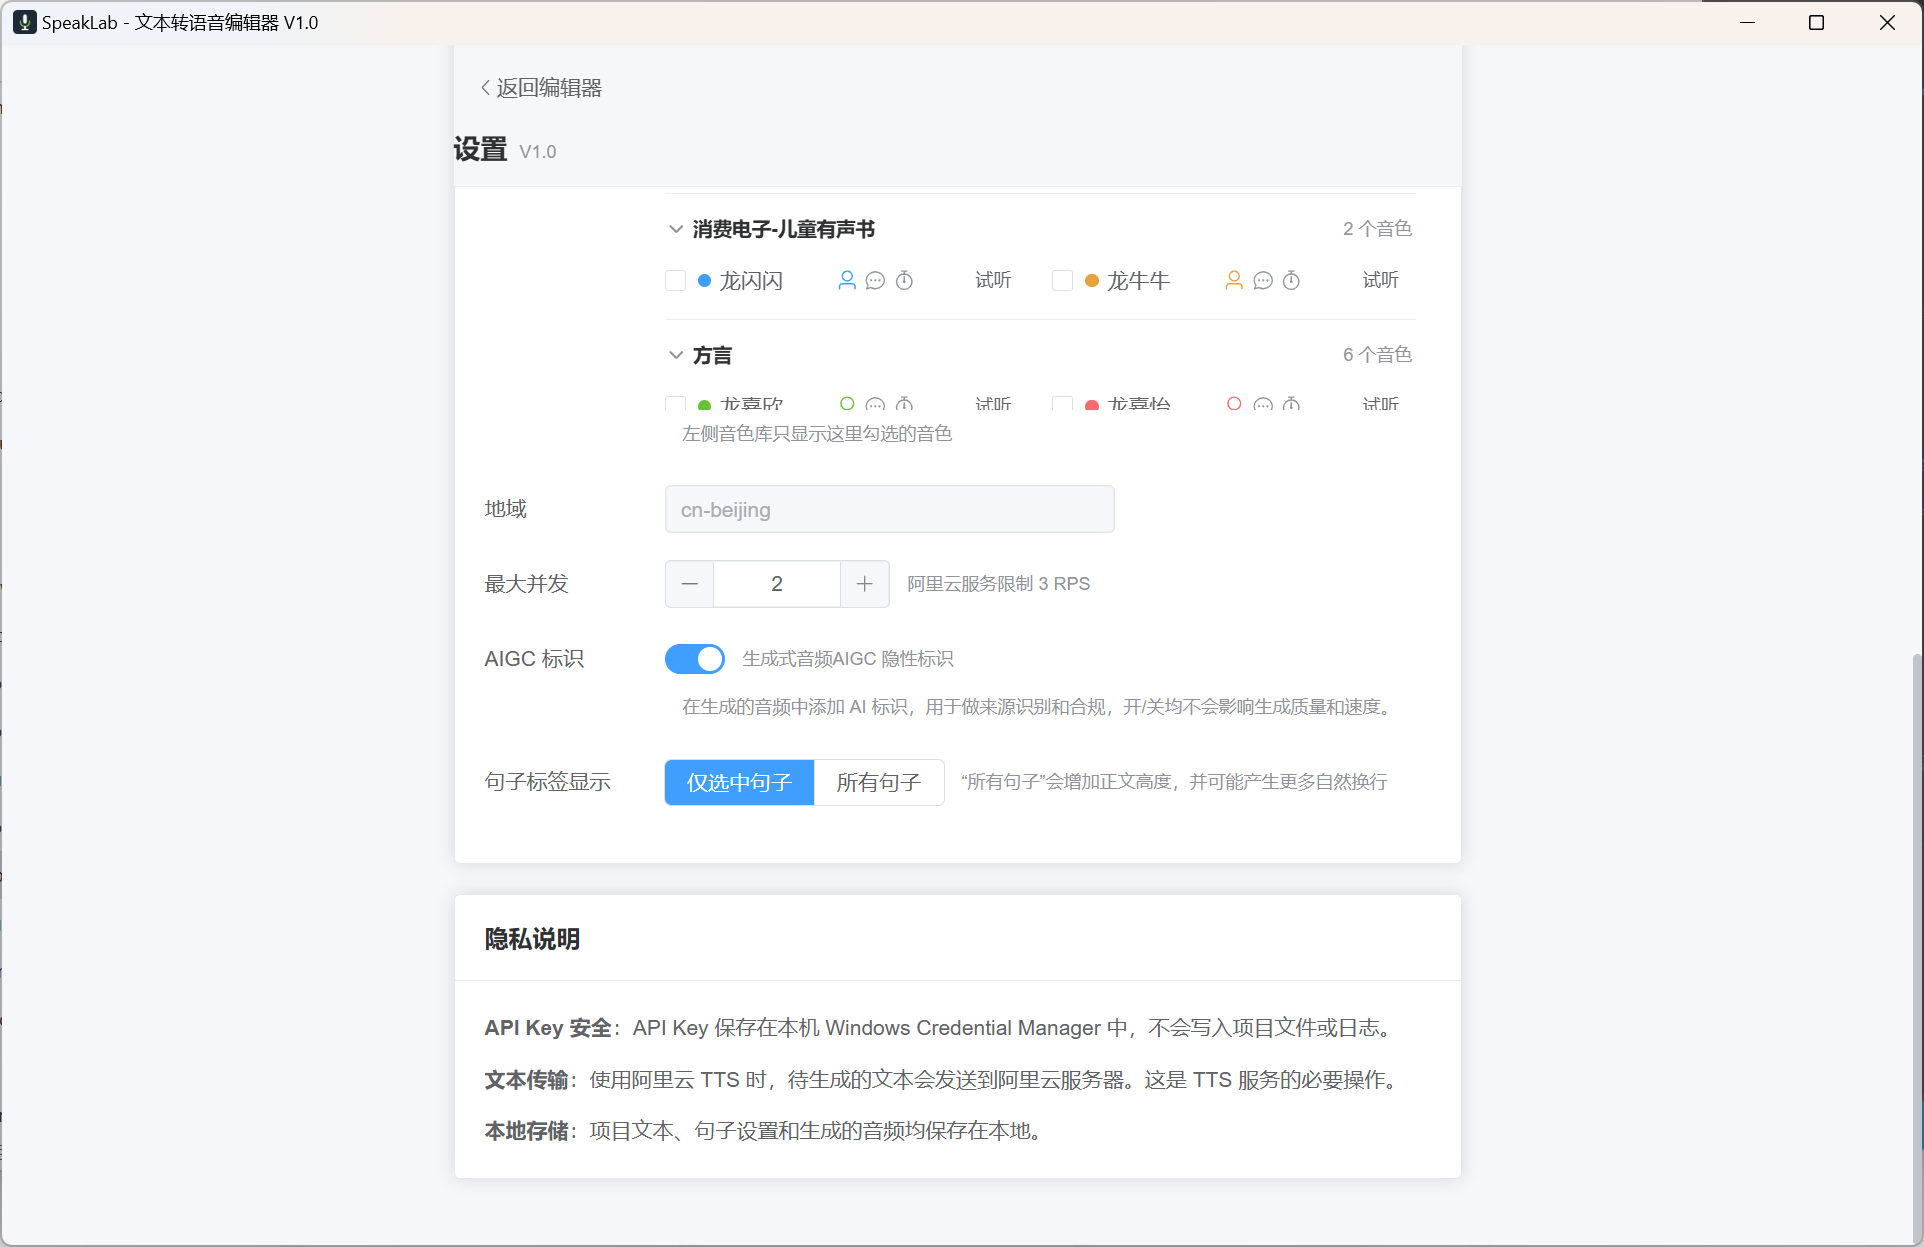
阿里云 API Key 使用 Windows Credential Manager 保存,不写入明文配置文件,也不输出到日志。
项目截图
以下为 SpeakLab 当前界面截图,点击图片可以查看大图。
当前状态与后续规划
- 当前第一版核心流程已打通,进入稳定性完善与能力扩展阶段。
- 当前已具备项目管理、自动分句、句子编辑、音色与参数配置、逐句生成、播放和 MP3 导出等基础能力。
- 后续重点包括生成队列、取消与重试、自动保存、完整撤销重做、时间戳与字幕导出,以及“我的音色”声音复刻。
- AI 角色识别和音色推荐只提供建议,用户确认后才会应用到句子。
当前打包的目标平台仅支持 Windows 桌面端。